2 Fotos
Ein Bild für die Person links und eines für rechts.
Bringe deine beiden Figuren als Duett ins orangefarbene Studio. Lade je ein Foto hoch. Liedtext oder Dialog sind optional; ohne Text wird die voreingestellte Performance verwendet.
Entdecke weitere Videomodelle für dein nächstes Projekt.
Hotel Lobby AI macht aus zwei Figurenfotos ein kurzes Duett im bekannten orangefarbenen Studio. Szene, Gesten und Ton sind voreingestellt. Lade zwei klare Bilder hoch und ergänze bei Bedarf kurze Liedtexte oder Dialoge.
Ein Bild für die Person links und eines für rechts.
Festes Duettformat mit 768P oder 2K.
Nutze die voreingestellte Gesangsdarbietung oder eigene Zeilen. Keine Musikdatei nötig.
Das orangefarbene Studio, Mikrofon und Duett sind voreingestellt. Zwei Fotos reichen aus; optionaler Liedtext oder Dialog gibt dem Gesang eine persönliche Note.
Verwende in jedem Feld ein scharfes Bild einer einzelnen Figur. Das erste Bild gehört zum linken, das zweite zum rechten Darsteller.
Das voreingestellte Duett braucht keinen Text. Für eigene Gesangs- oder Dialogzeilen ergänze kurze selbst verfasste Texte und gib die Sprache sowie den linken oder rechten Sprecher an. Aussprache und Timing können variieren.
Dieser Effekt nutzt MiniMax H3. Wähle 768P oder 2K und prüfe die geschätzten Credits. Anmeldung und ausreichend Credits erforderlich; jeder Durchlauf wird separat berechnet.
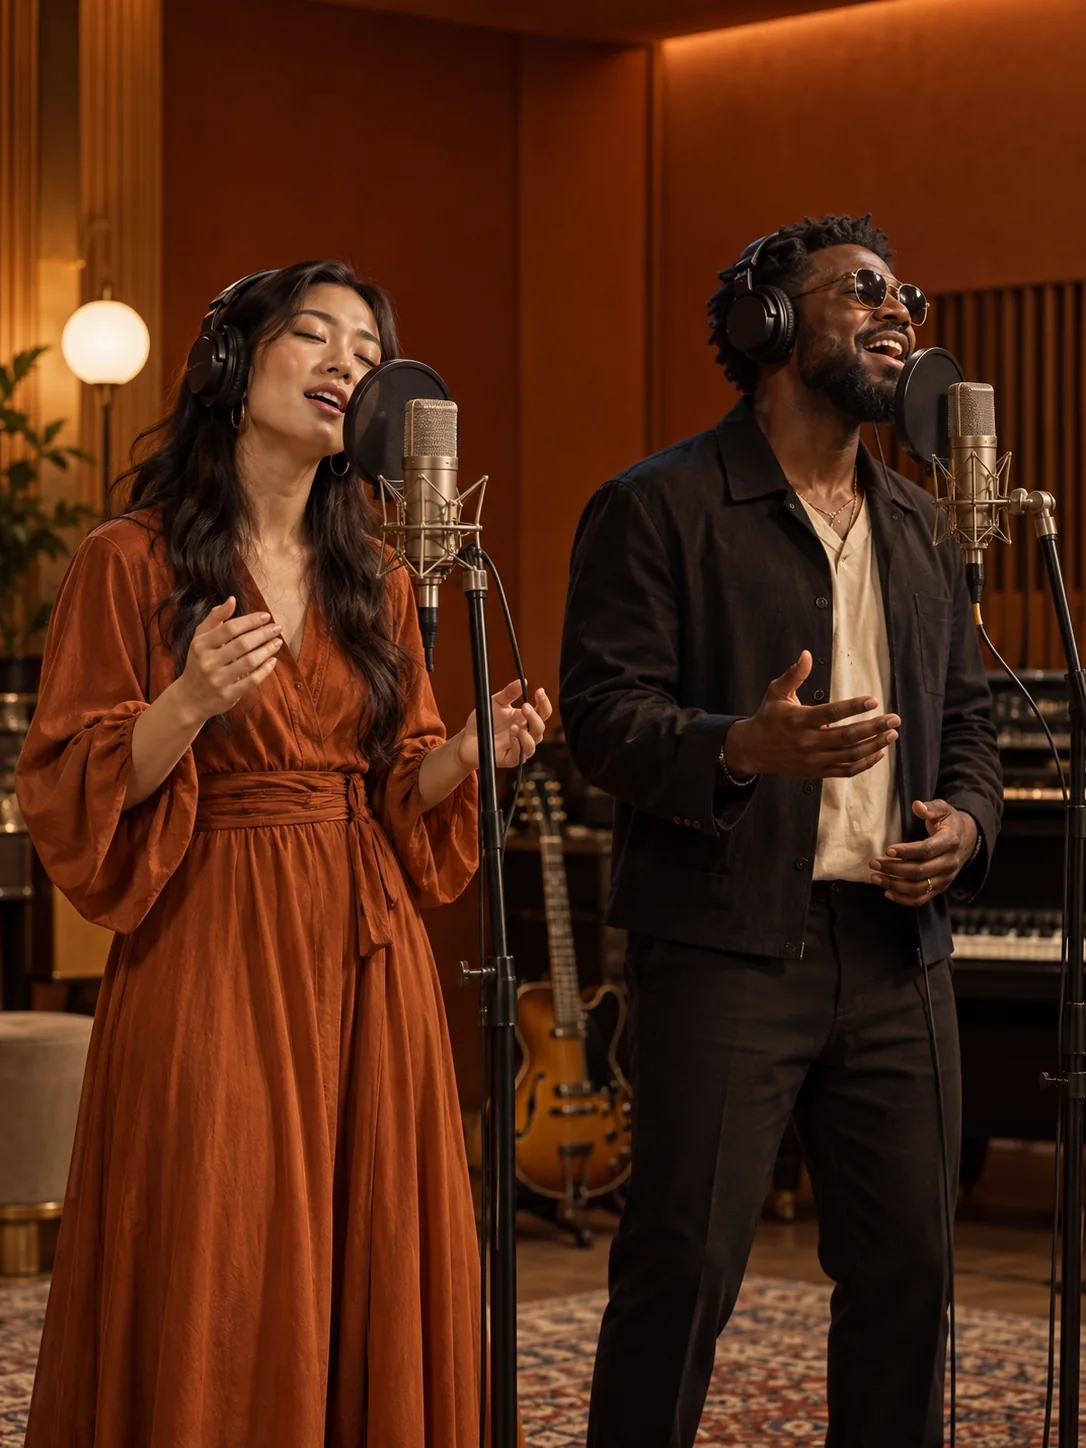
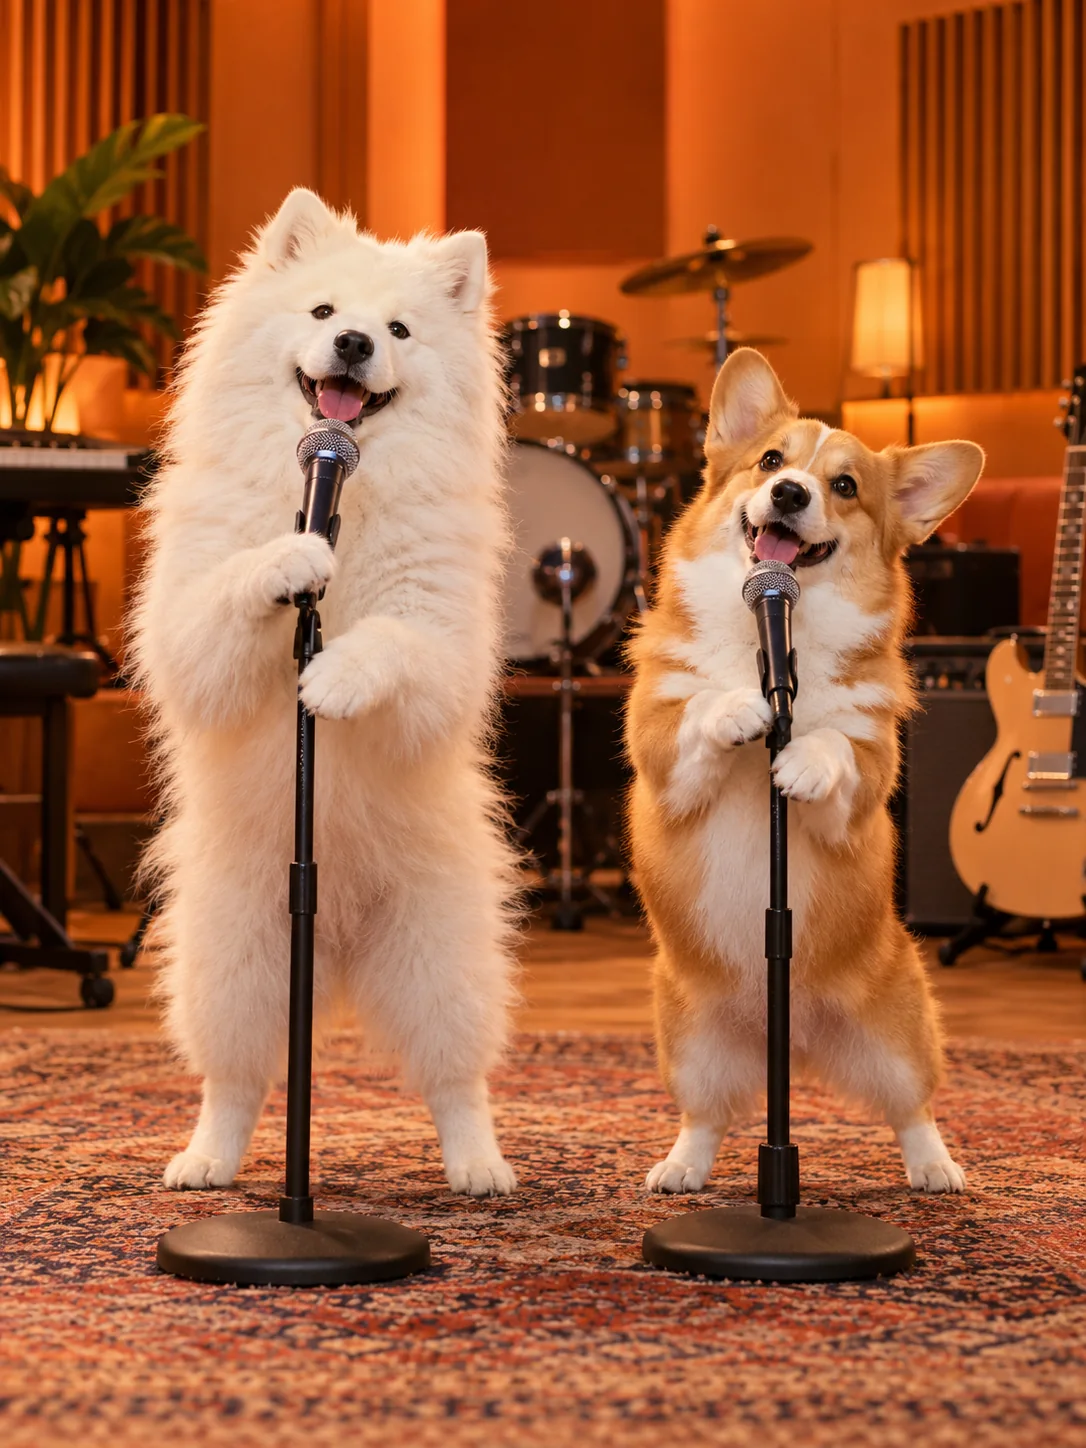
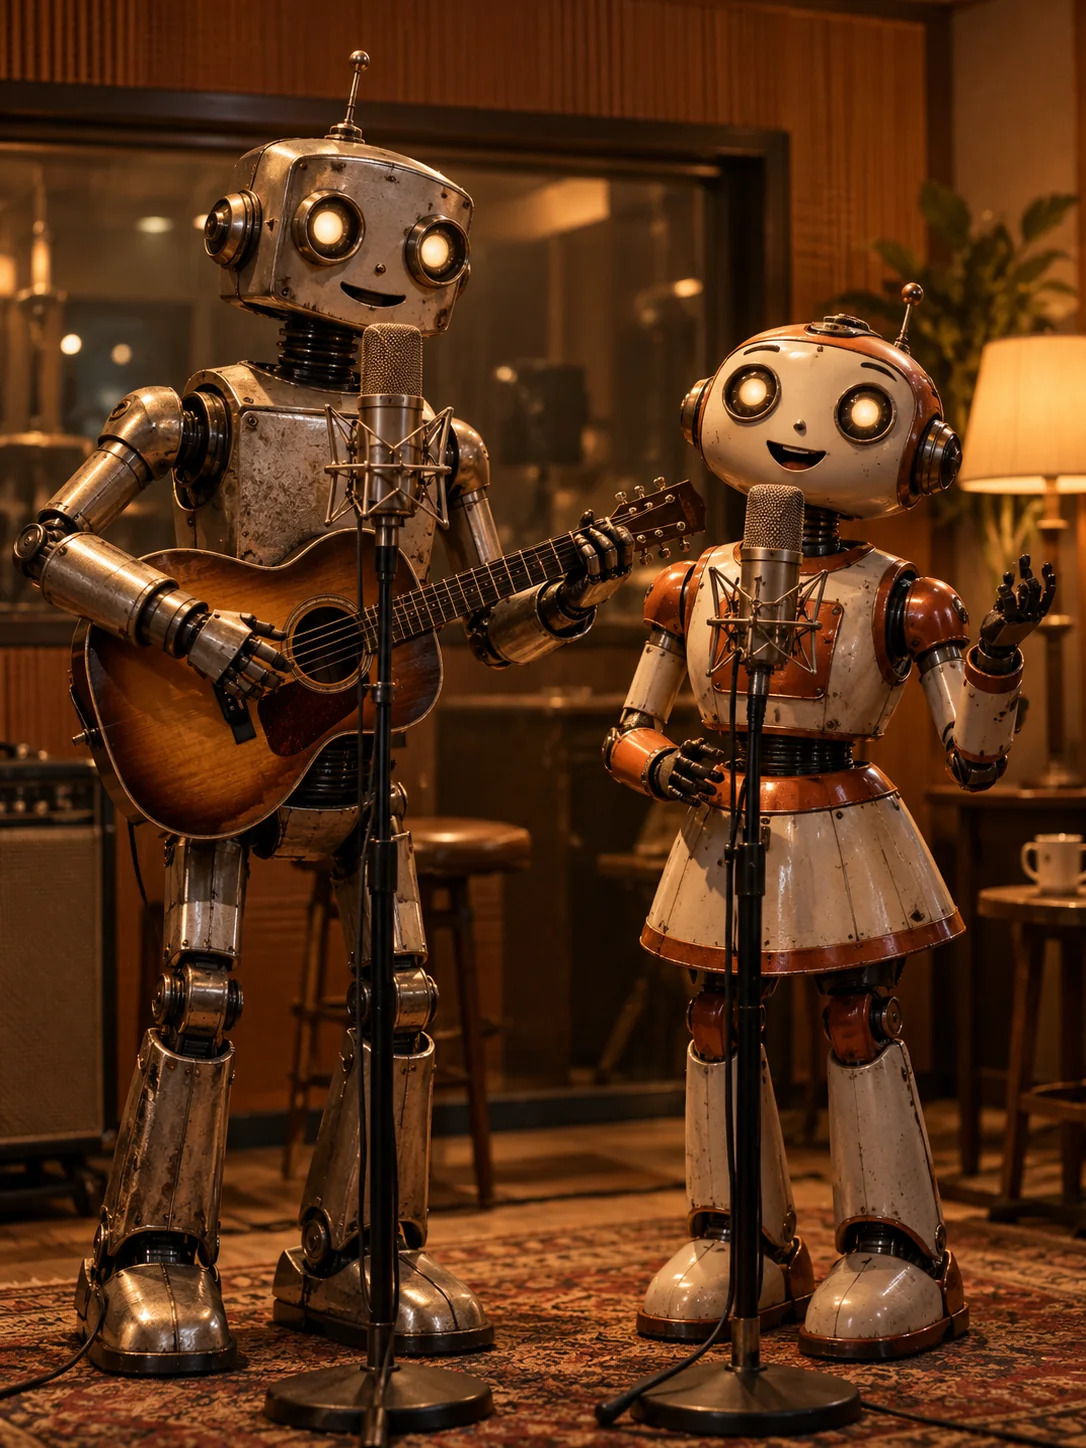
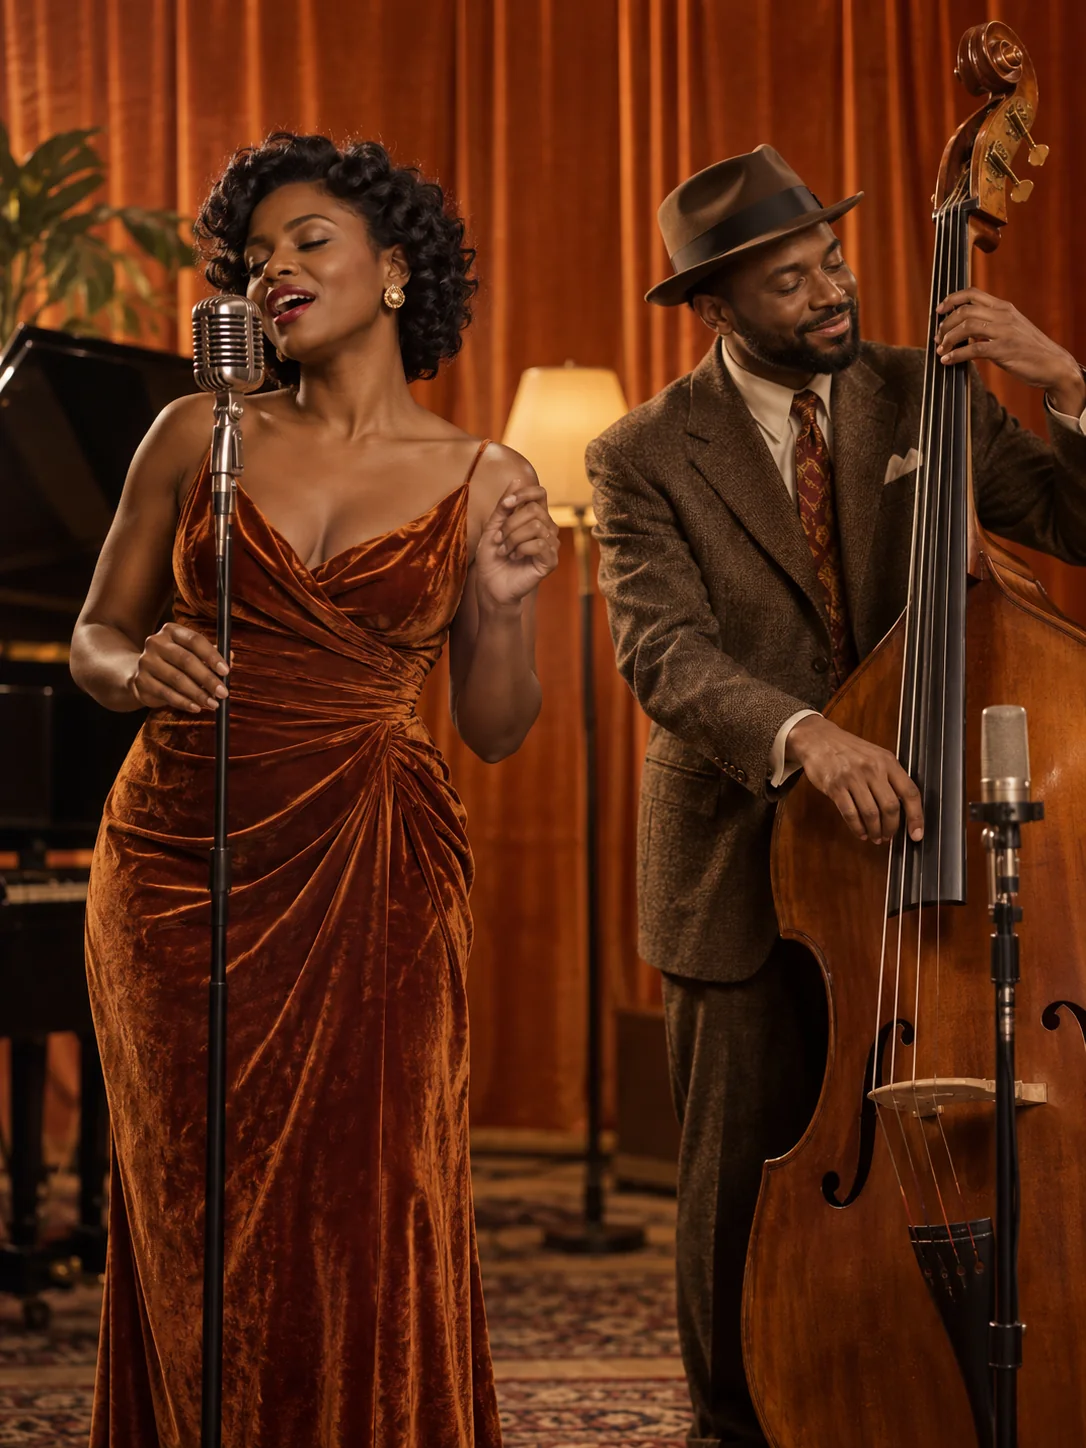
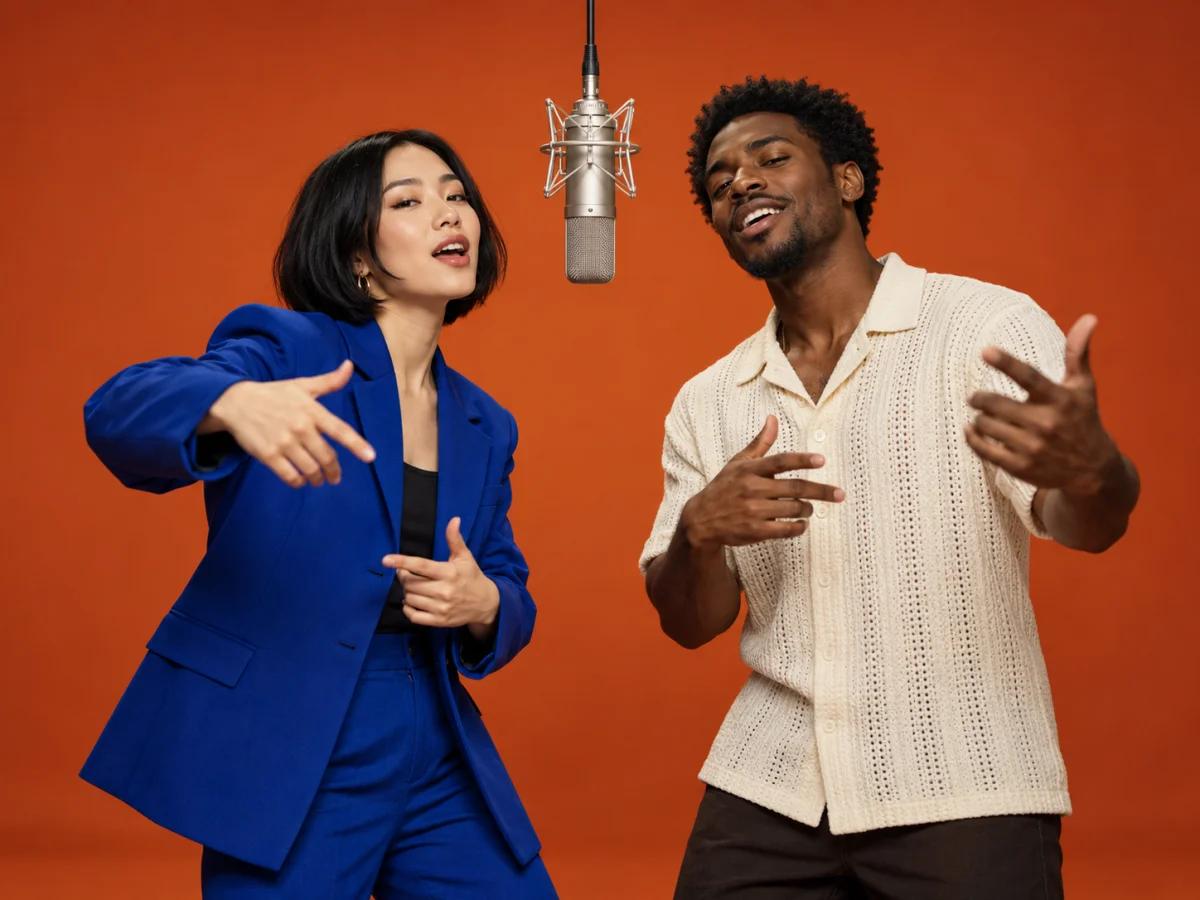
Diese KI-Konzeptbilder zeigen kreative Richtungen. Sie sind keine Ergebnisse oder Leistungsnachweise von MiniMax H3.
Gestalte aus zwei Porträts einen freundlichen musikalischen Austausch. Nutze die Voreinstellung oder personalisiere die Stimmen mit eigenen Zeilen, ohne einen vollständigen Generierungs-Prompt zu schreiben.
Wähle Einzelporträts von vorn oder leicht seitlich. Vermeide kleine Gesichter, starke Unschärfe und Gruppenfotos. Achte darauf, dass die Details sichtbar sind, die das Modell beibehalten soll.
Optional kannst du ergänzen: Links sagt „Wir sind am Mikrofon angekommen“, rechts antwortet „Jetzt kann die gute Zeit beginnen“. Nenne die Sprache und halte den Austausch kurz; Szene und Gesten übernimmt der Effekt.
Prüfe vor dem Teilen Gesichter, Mundbewegungen, Ton und Übergänge. Die Voreinstellung gibt eine einheitliche Richtung vor, garantiert aber keine identischen Gesichter, einen exakten Wortlaut oder perfekte Lippensynchronität.
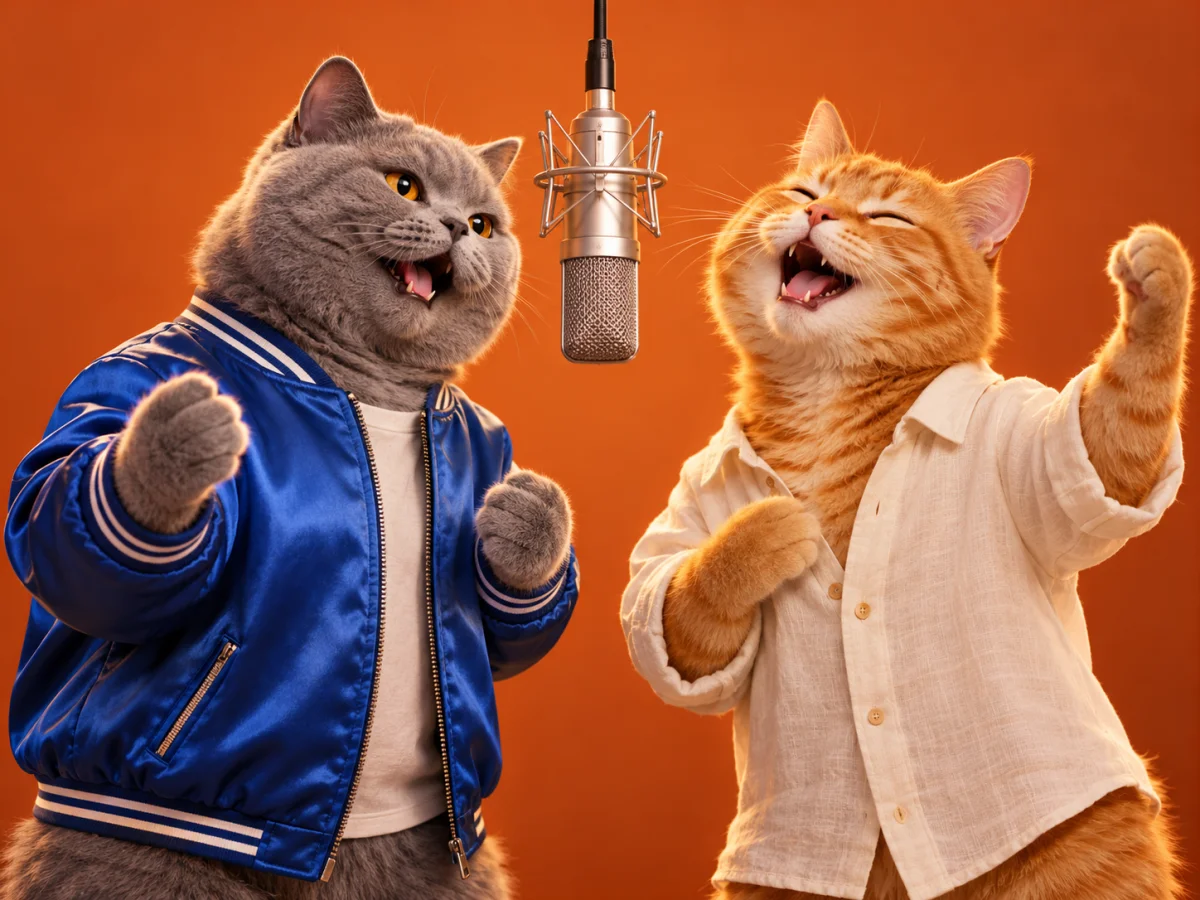
Probiere Haustiere oder gezeichnete Figuren für ein verspieltes Duett. Der Effekt gibt Szene und Rhythmus vor; wähle zwei gut erkennbare Referenzbilder.
Lade jede Figur einzeln hoch. Referenzen lenken das Aussehen, doch stilisierte Körper, Pfoten und Kleidung können sich verändern.
Die Voreinstellung führt durch abwechselnde Gesten und einen lebhaften Gesangsaustausch. Lass das Textfeld leer oder ergänze eine kurze eigene Zeile.
Ist eine Figur schwer zu erkennen, wähle ein klareres Porträt. Wirkt der Gesang gehetzt, kürze die optionalen Zeilen. Jeder neue Durchlauf kostet Credits.
Lade je ein JPEG, PNG oder WebP für links und rechts hoch. Beide Fotos sind erforderlich.
Wähle Qualität und Seitenverhältnis und prüfe die Credits. Liedtext oder Dialog sind optional; ohne Text entsteht das voreingestellte Duett.
Die Vorschau zeigt zunächst das bereitgestellte Video. Nach erfolgreicher Generierung ersetzt dein Ergebnis die Vorschau. Spiele es mit Ton ab, prüfe das Duo und lade es herunter.
Zwei Figurenbilder, eines pro Darsteller. Ein Prompt sowie Video- oder Musikdateien sind nicht erforderlich. Szene und Performance sind integriert; Liedtext oder Dialog sind optional.
Ja, optional. Ergänze kurze eigene Liedtexte oder Dialoge, nenne die Sprache und ordne zitierte Zeilen dem linken oder rechten Darsteller zu. Der Effekt kombiniert diesen Gesangsinhalt mit seinen festen Szenen- und Performance-Anweisungen. Wortlaut, Stimmen und Lippensynchronität können variieren.
Dieser Effekt verspricht keine Kopie des Originalsongs oder einer bestimmten Aufnahme. Die Voreinstellung sieht einen eigenen lebhaften Groove mit wortlosem Gesang vor. Optionaler Liedtext oder Dialog passt den Gesangsinhalt an.
Der Effekt verwendet MiniMax H3 mit einer festen Dauer von 15 Sekunden. Wähle das Seitenverhältnis und 768P oder 2K; das Standardverhältnis ist 4:3. Für andere Modelle, Dauern und Referenzabläufe nutze die Videomodellseiten.
Referenzen lenken das Aussehen, aber Gesichter, Kleidung und Gesten können sich verändern. Nutze klare Einzelbilder und prüfe den gesamten Clip auf vermischte Identitäten, verzerrte Hände und Lippenbewegungen.
Die Generierung erfordert Anmeldung und SceneFlare-Credits. Die Schätzung umfasst das Referenzvideo und die gewählte Qualität. Die erste Vorschau ist das bereitgestellte Video, kein Ergebnis aus deinen Fotos. Die Bilder darunter zeigen kreative Ideen, keine erfolgreichen Durchläufe dieses Effekts.
Lade für jeden Darsteller ein Foto hoch und wähle das Format. Nutze das voreingestellte Duett oder ergänze eigene Zeilen.
KI-generierte Gestaltungsideen, keine getesteten Ergebnisse des vorgestellten Modells oder Tools.