2 张图片
左侧和右侧表演者各一张图片。
让你的两个角色在橙色录音棚中同台表演。每个角色上传一张图片;歌词或对白可以选填,留空即可使用默认表演。
Hotel Lobby AI 将两张角色图片转化为橙色录音棚中的双人短片。场景、动作和声音由内置特效设定。上传两张清晰图片即可,也可选填简短歌词或对白。
左侧和右侧表演者各一张图片。
固定双人表演格式,可选择 768P 或 2K。
使用默认人声表演,也可加入自己的台词,无需上传音乐。
橙色录音棚、麦克风和双人表演均已内置。只上传两张图片就能生成,也可选填歌词或对白,让人声更有个人特色。
每个上传位置使用单个角色的清晰图片。第一张图片对应左侧表演者,第二张对应右侧。
默认表演无需填写文字。如需定制人声,可输入简短原创歌词或对白,注明语言和左右表演者。发音和节奏可能有所变化。
本特效使用 MiniMax H3。选择 768P 或 2K 后,查看生成前的积分预估。需要登录和足够积分,每次生成分别计费。
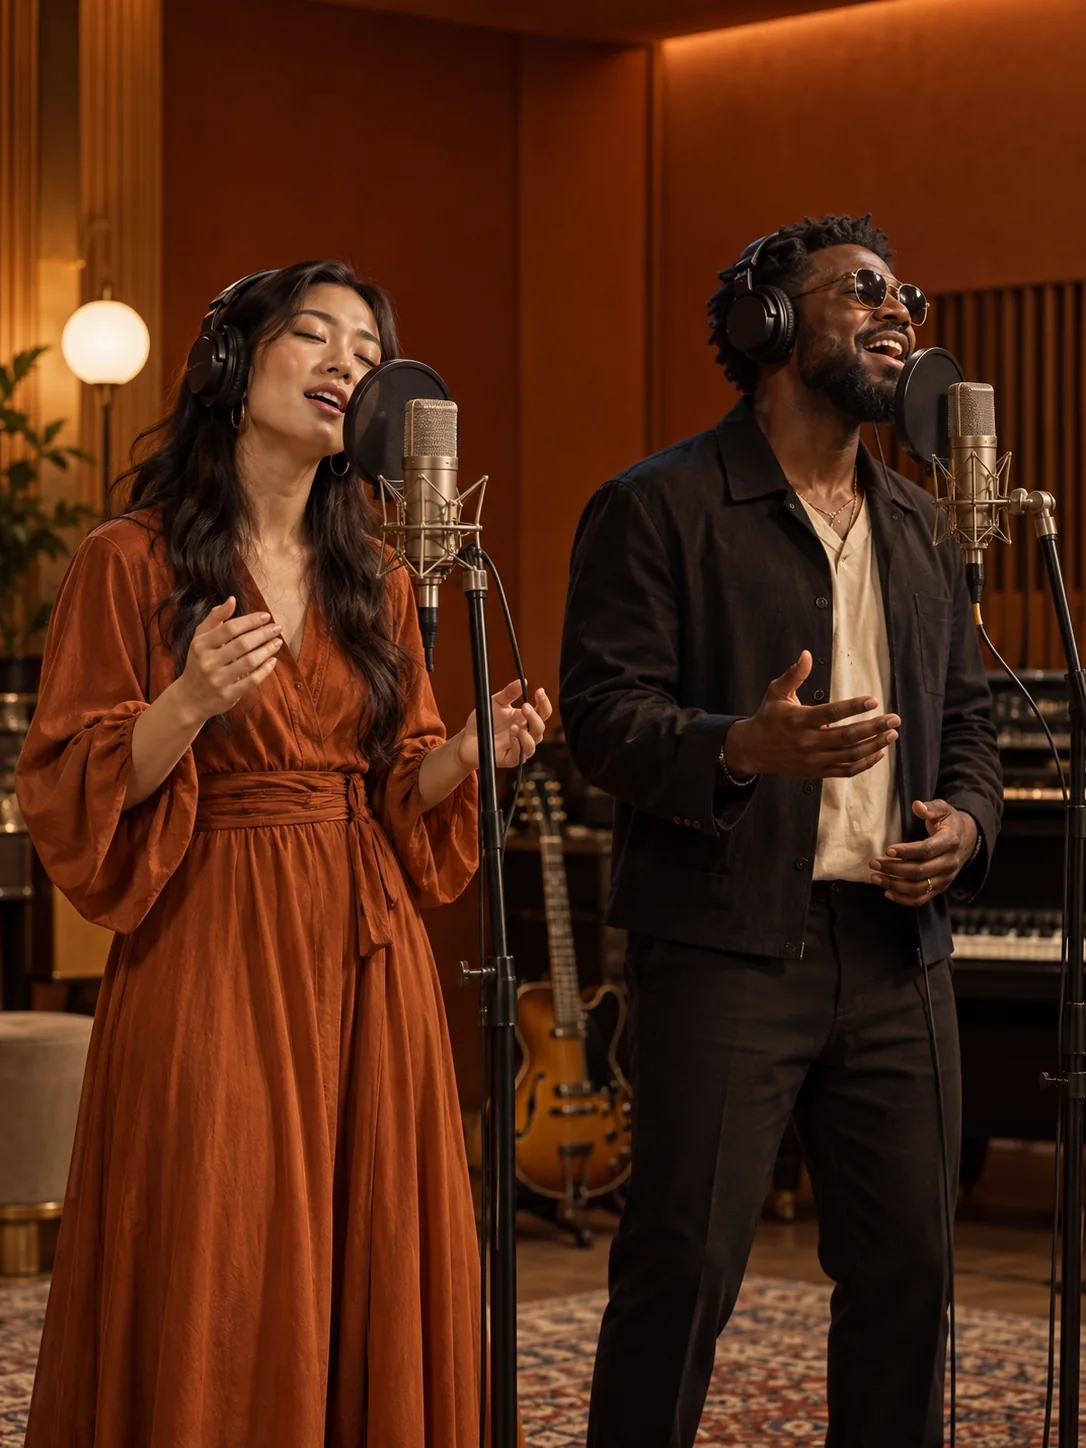
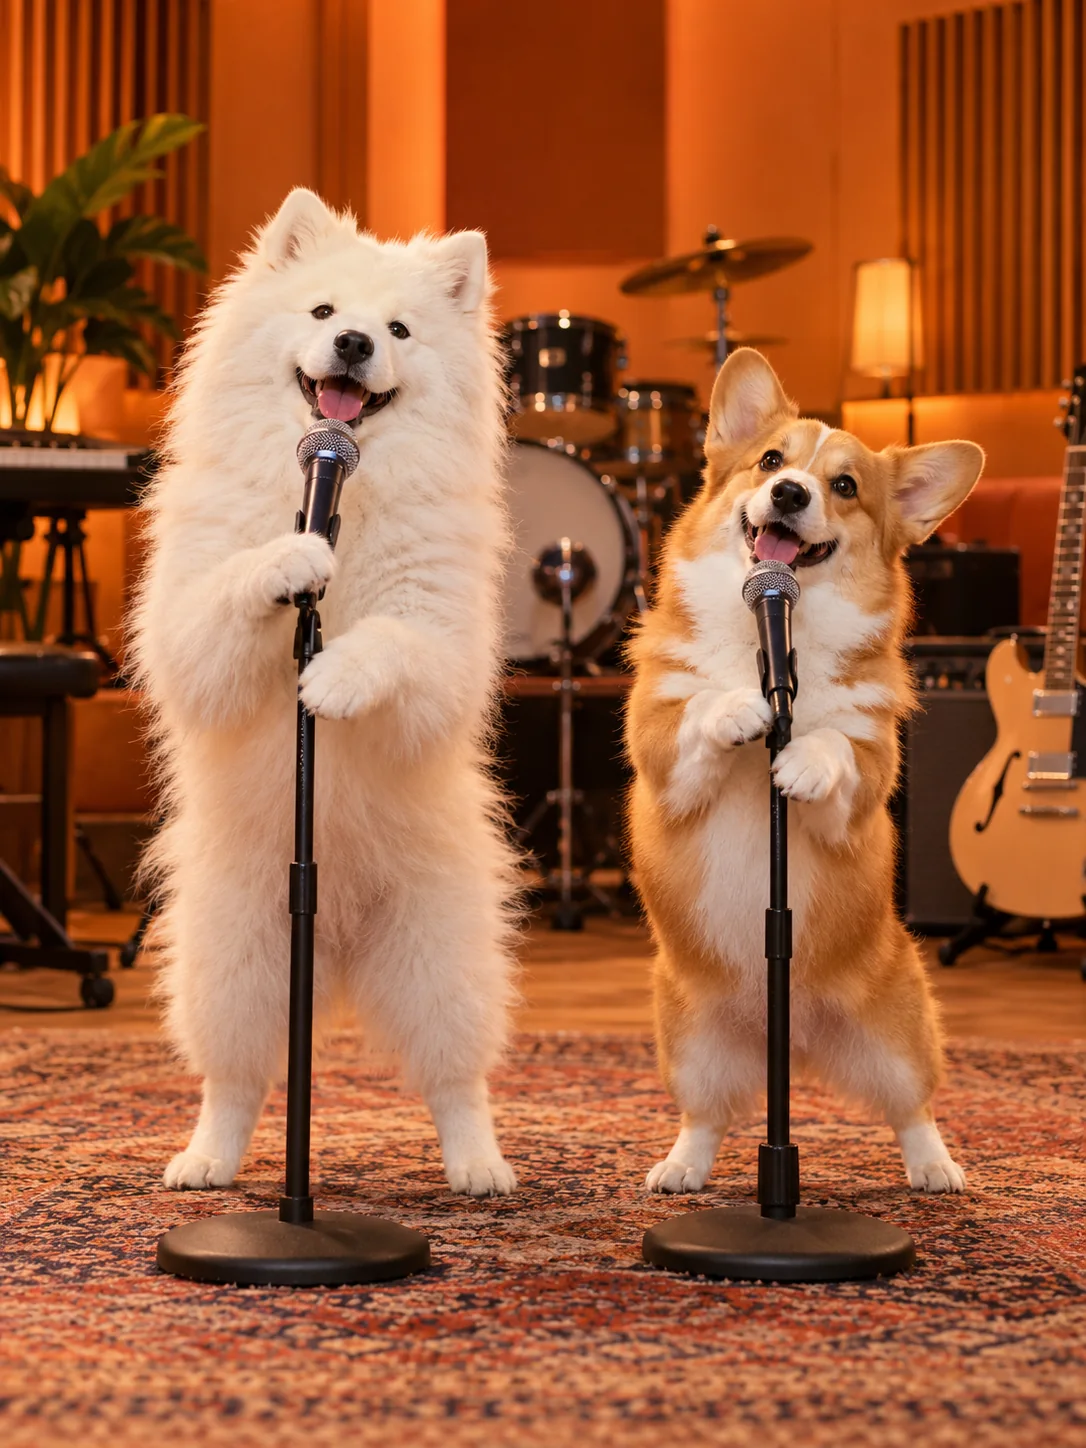
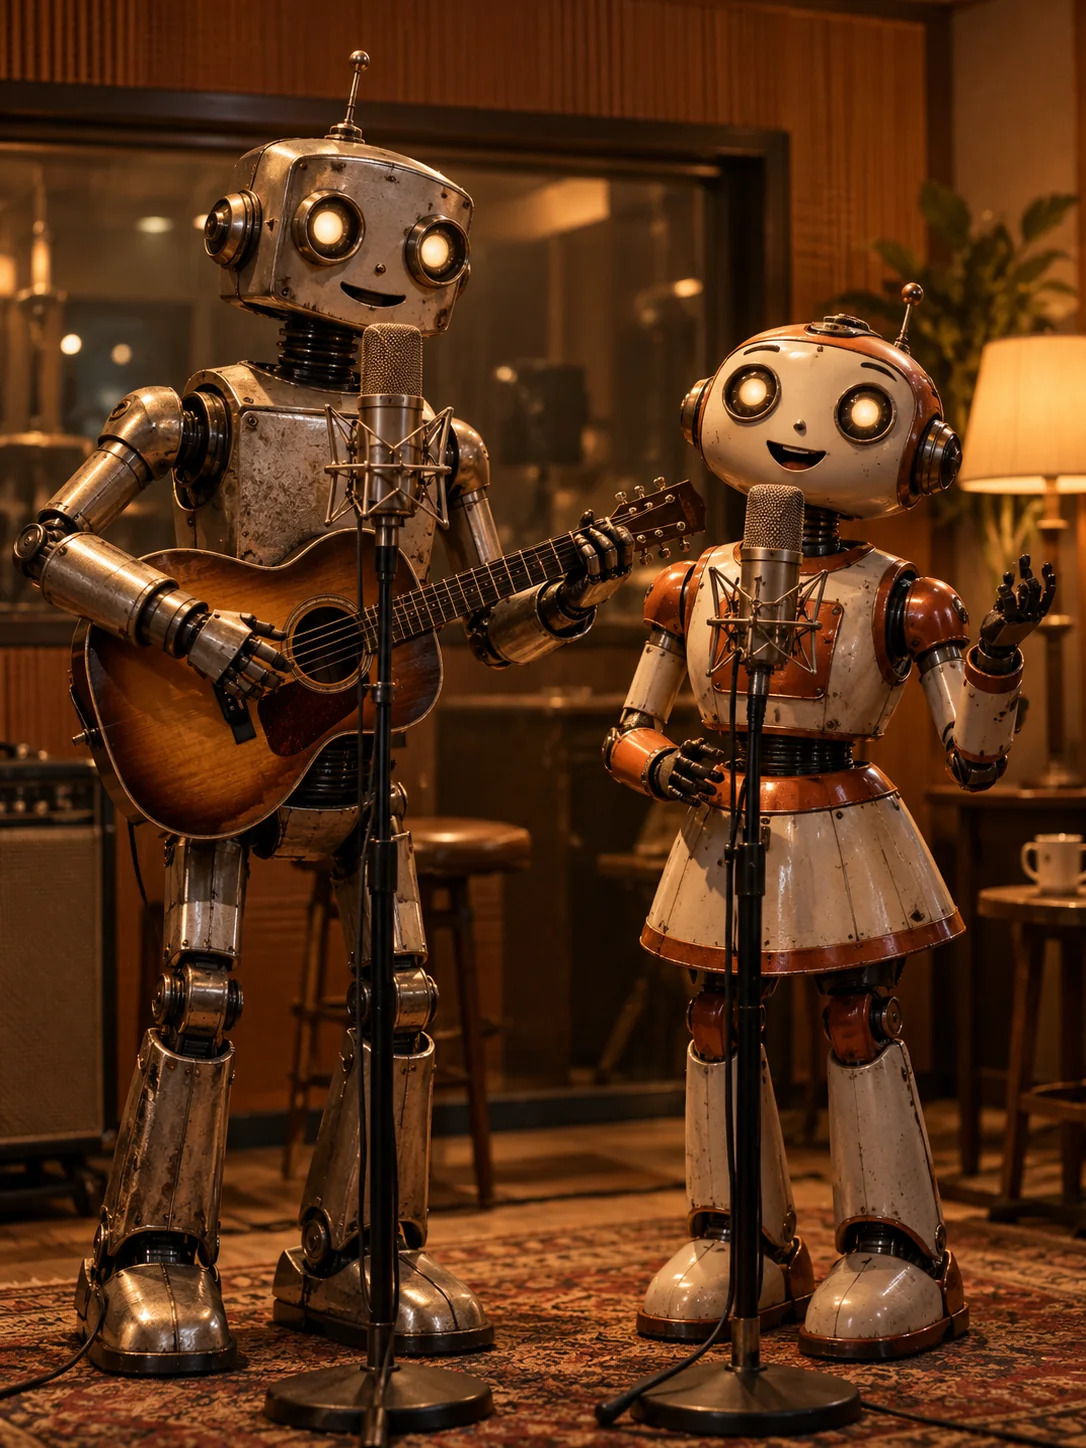
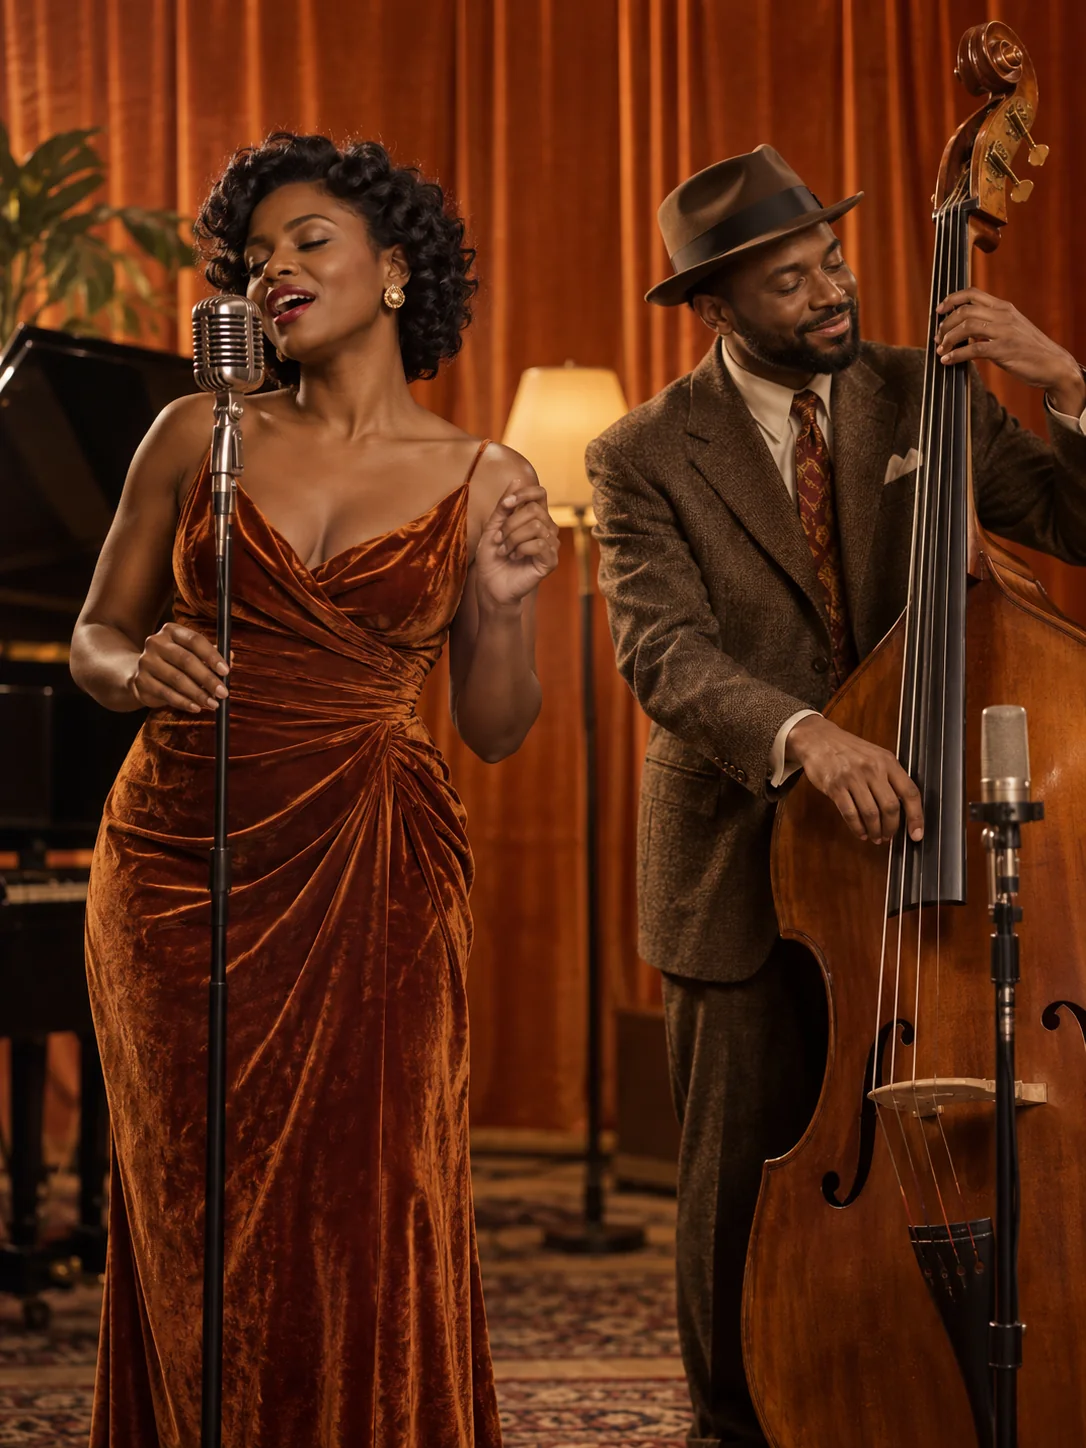
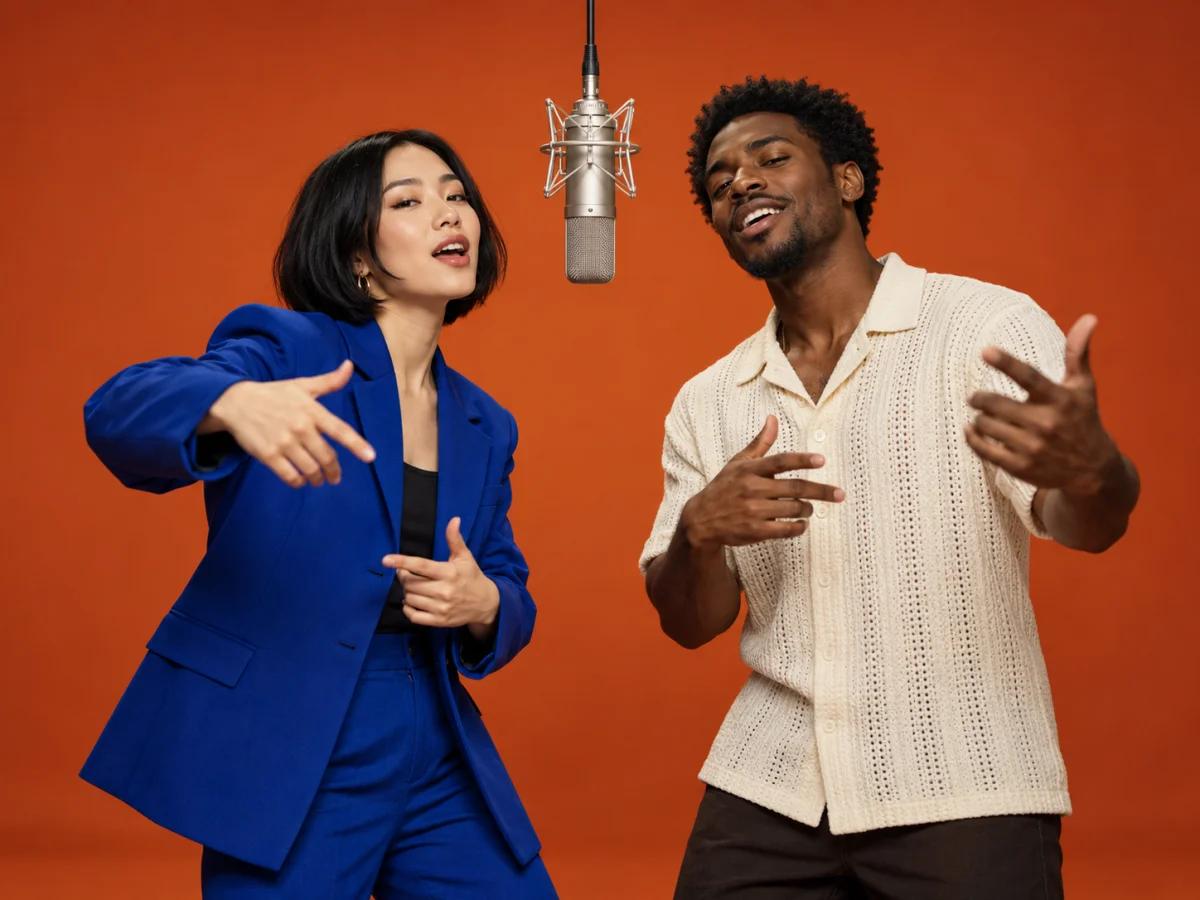
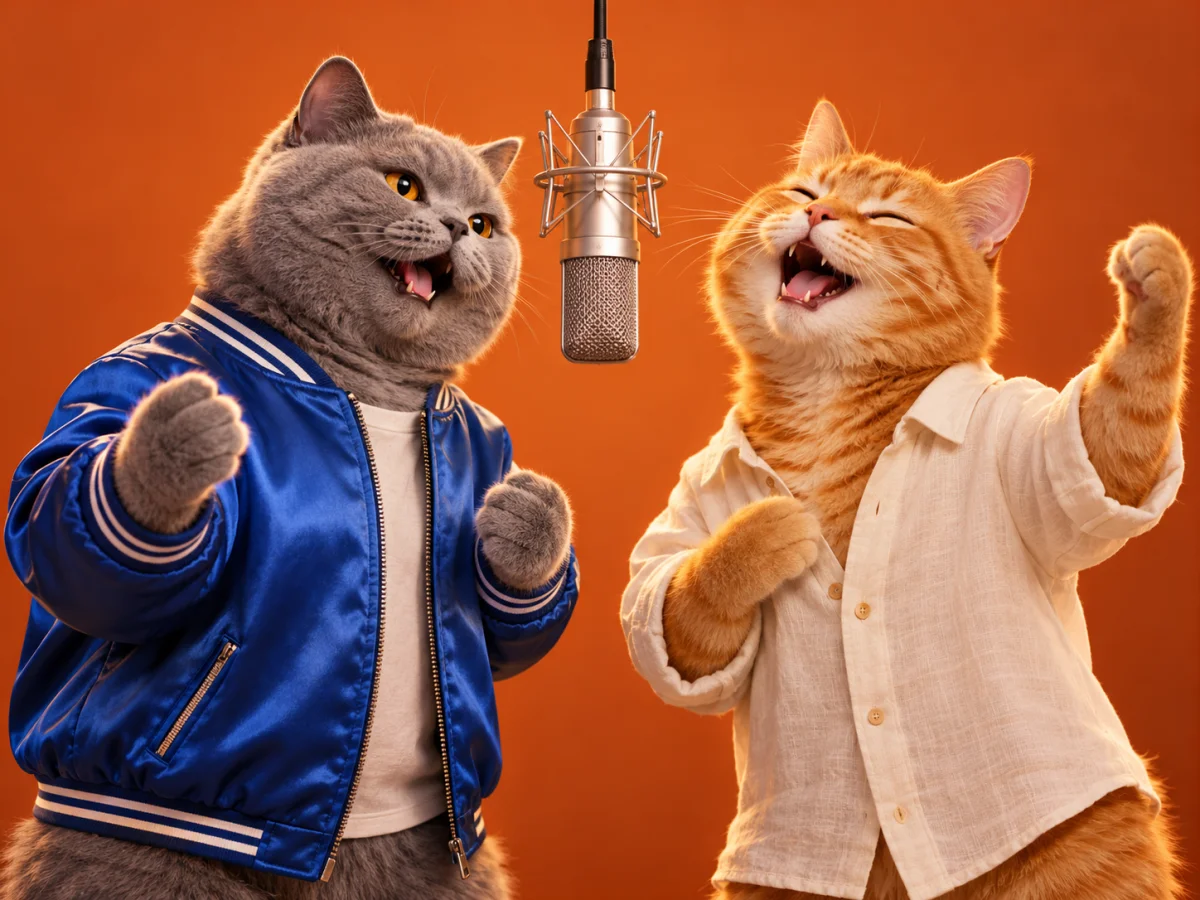
这些 AI 生成的静态图用于展示创作方向,并非 MiniMax H3 的生成结果或性能证据。
用两张人物照制作轻松的音乐互动。保留内置表演,或加入几句原创台词来定制人声,无需编写完整生成提示词。
选用单人正面或略微侧面的照片。避免面部过小、严重模糊和合照,保留你希望模型延续的可见细节。
可选填:左侧说“我们来到麦克风前”,右侧回应“现在让快乐开始”。注明语言并保持台词简短,场景和动作由内置特效安排。
分享前检查面部、口型、声音和衔接。预设统一创作方向,但不保证面部完全一致、台词逐字准确或口型完美同步。
尝试宠物或插画角色,制作轻松的双人概念短片。内置特效安排场景与节奏,请选择两张角色特征清晰的参考图。
两个角色分别上传。参考图用于引导外观,但动画中角色的身体造型、爪子和服装可能变化。
预设引导交替手势和轻快的人声互动。文字栏可以留空,也可加入一句简短原创台词供角色表演。
角色不易辨认时,可换用更清晰的图片。人声互动过于匆忙时,可缩短选填台词。每次新生成都消耗积分。
为左侧和右侧表演者分别上传一张 JPEG、PNG 或 WebP,两张图片都必填。
选择画质和画面比例,查看积分预估。歌词或对白为选填项,留空即可使用默认双人表演。
预览区先显示提供的视频,生成成功后会替换为你的结果。播放有声结果,检查两个角色后下载。
上传两张角色图片,每个表演者一张。无需编写提示词,也不用上传视频或音乐。特效内置场景和表演,歌词或对白可以选填。
可以,但不是必填项。输入简短原创歌词或对白,注明语言,用引号标出台词并分配给左右表演者。特效会将这些人声内容与内置场景、表演指令组合。具体台词、声线和口型同步可能有所变化。
本特效不承诺复制原版歌曲或特定录音。默认指令安排原创轻快伴奏和无歌词人声。选填歌词或对白可以定制人声内容。
本特效使用 MiniMax H3,时长固定为 15 秒。可选择视频比例和 768P 或 2K 画质,默认比例为 4:3。其他模型、时长和参考工作流程请使用视频模型页面。
参考图会引导外观,但面部、服装和手势可能变化。请使用清晰单人照,并检查整个视频中是否有身份混合、手部失真或口型问题。
生成需要登录并消耗 SceneFlare 积分,预估包含参考视频输入和所选画质。初始预览是提供的视频,并非由你的图片生成的结果。下方静态图用于展示创作方向,也不是本特效成功生成的视频。